本文定位:面向开发者与数据工程师——在大模型训练语料、评测集与 AI 搜索引擎索引的建设中,当采集规模扩大、目标站点出现高频访问限制时,如何用分布式代理池保障采集的持续性。先说清一件事:分布式代理池提供的是网络出口与故障隔离,它不增加数据源授予你的总访问额度。本文的方案只适用于你已获准访问的数据源(官方 API、获许可数据集、robots.txt 与站点条款允许的网页访问),不适用于绕过任何访问限制。
简短回答:持续性来自哪里
简短回答:语料采集的持续性来自四件事——获准的数据源(入口优先级:官方 API > 获许可数据集 > 站点 Feed > 条款允许的网页访问)、共享的配额与退避调度(所有工作节点、地域和出口共享同一份预算——切换出口不重置预算,一个节点收到 429 所有节点一起退避)、故障恢复(检查点、幂等任务、有限重试),以及可追溯的语料(来源 URL、获取时间、许可状态等元数据)。分布式代理池解决的是网络层问题——出口可用性、地域分布、故障隔离;它不能替代授权、不能替代调度、更不能把"限流"变成"不限流"。
先分清:你要的语料是哪种用途
不同用途对应不同的许可核对要求,不能混用一套判断:
| 用途 | 典型场景 | 必须核对什么 |
|---|---|---|
| 模型训练 | 预训练/继续训练语料 | 数据许可(可否用于训练)、版权状态、站点条款 |
| 模型评测 | 基准测试集 | 评测集自身的使用条款(部分基准禁止训练用) |
| RAG / 搜索索引 | AI 搜索引擎的检索库 | 抓取许可(robots.txt)、展示与摘要规则、内容时效 |
一个关键澄清:robots.txt 允许 ≠ 内容可任意使用。RFC 9309 明确 robots.txt 是服务所有者对爬虫的访问规则,"不是访问授权机制",也不能替代有效的内容安全措施(RFC 9309);Google 官方文档也强调 robots.txt 主要用于管理抓取流量,"不是让网页不出现在搜索里的机制"(Google 文档)。"公开可访问"、"robots 允许"、"拥有使用许可"是三个不同的判断,不能互相替代。
大模型厂商自己也在遵守这套边界——可以对照它们的官方实践:
- OpenAI 区分了不同用途的爬虫:GPTBot(抓取可能用于训练生成式 AI 基础模型的内容)、OAI-SearchBot(搜索用途,让网站出现在 ChatGPT 搜索结果中)、ChatGPT-User(用户触发的特定访问,robots 规则可能不适用)——其中 GPTBot 与 OAI-SearchBot 的 robots.txt 设置彼此独立——站点可以允许搜索用途同时禁止训练用途;ChatGPT-User 是用户触发的访问,官方说明 robots 规则可能不适用(OpenAI 文档);
- Google 的 Google-Extended 是一个 robots.txt 控制标记,用于管理抓取内容是否可用于 Gemini 模型训练与 grounding——注意它不是独立的 HTTP User-Agent:官方文档明确"Google-Extended 没有单独的 HTTP 请求 user agent 字符串,抓取由现有 Google UA 完成,robots.txt 标记只用于控制用途"(Google 文档);
- Common Crawl 的 CCBot 在抓取页面之前先检查 robots.txt,遵守其规则(包括非标准的 Crawl-delay 扩展),并通过 opt-out 登记表处理出版者的移除请求(Common Crawl FAQ)。
红线:不要冒用 GPTBot、CCBot 等真实爬虫的身份标识——OpenAI 与 Common Crawl 都公布了验证方法(IP 范围 JSON、反向 DNS),冒名无法通过验证。你的采集器应使用自己的可识别身份。
数据入口的优先级
在写任何爬虫之前,按优先级检查有没有"更正"的入口:
- 官方 API:多数平台对开发者提供正式接口,配额、认证、速率限制都写在文档里——需要更高访问量时这是正规通道(注意 API 同样受额度、用途与内容权利限制);获许可的批量交付或其他明确授权同样可能是入口;
- 获许可的数据集/批量下载:例如 Common Crawl 的网页存档(托管在 AWS 公共数据集上,可免费分析或下载)——但注意其使用条款把版权合规责任明确交给使用者:"抓取内容可能另受其所有者的独立条款约束,使用者须尊重第三方材料的版权及其他权利,商业使用前建议咨询法律顾问";
- 站点提供的 Feed/导出:RSS、Sitemap、结构化导出比抓取 HTML 更稳定也更受欢迎;
- 条款允许的网页访问:前三者都没有时,才是 robots.txt 与站点条款允许下的网页抓取。
注意:"数据集可以下载"不等于"任意内容均可用于训练"——Common Crawl 条款还禁止"将个人身份信息单独从抓取内容中收集或提取使用"(条款)。训练用途的许可核对(版权、处理目的)是独立于抓取的步骤。
高频访问限制的三种含义
面对限制,先分类,再行动——不同的限制对应完全不同的正确动作:
| 现象 | 含义 | 正确动作 | 错误动作 |
|---|---|---|---|
| 429 Too Many Requests | 你超过了目标允许的速率(MDN) | 读取 Retry-After 头(整数秒或 HTTP-date,RFC 9110),共享退避 | 换出口继续发——限流按账户/IP/密钥等维度记账,换出口只会加速耗尽信任 |
| 403 / robots 禁止 / 质询 | 目标策略拒绝了你 | 暂停任务,检查许可、认证与目标要求 | 换 IP 突破(见上一篇对质询机制的分析) |
| 明确归因于出口层的故障(代理拒绝连接等) | 你的代理出口问题 | 切换健康出口,预算与退避状态不变 | 把超时/连接异常一概当出口故障——它们也可能来自目标服务(见上一篇的失败分类),归因错误会误换出口或误伤节点 |
| 目标 5xx | 目标服务故障 | 有限重试或延期 | 判代理死亡(见上一篇的失败分类) |
为什么 429 不能换出口重发:HTTP 429 的限流"可以是服务器范围的或针对特定资源的,通常基于客户端 IP,也可以在请求经过身份验证或包含 Cookie 时针对用户或已授权应用"(MDN)——限流维度可能不是 IP。即使某站按 IP 限流,用出口轮换规避它也违反了目标的速率意图,且共享退避(所有节点一起慢下来)总是比"每个出口各冲一次"更接近目标的真实要求。
分布式架构:共享配额与分布式出口
这是全文的核心架构(配套参考实现的演示版):
数据源与使用许可清单(获准目标)
        ↓
URL 前沿 / 任务队列 → 共享准入与配额调度器(robots 检查 → 原子准入)
        ↓                          ↑
有界工作节点集群(多地域/多出口)    │ 共享退避表(429 反馈)
        ↓                          │
   获准出口 / 代理池 ──────────────┘
        ↓
   数据源(获准)
        ↓
原始记录 → 清洗去重 → 来源与许可元数据 → 训练/索引用途
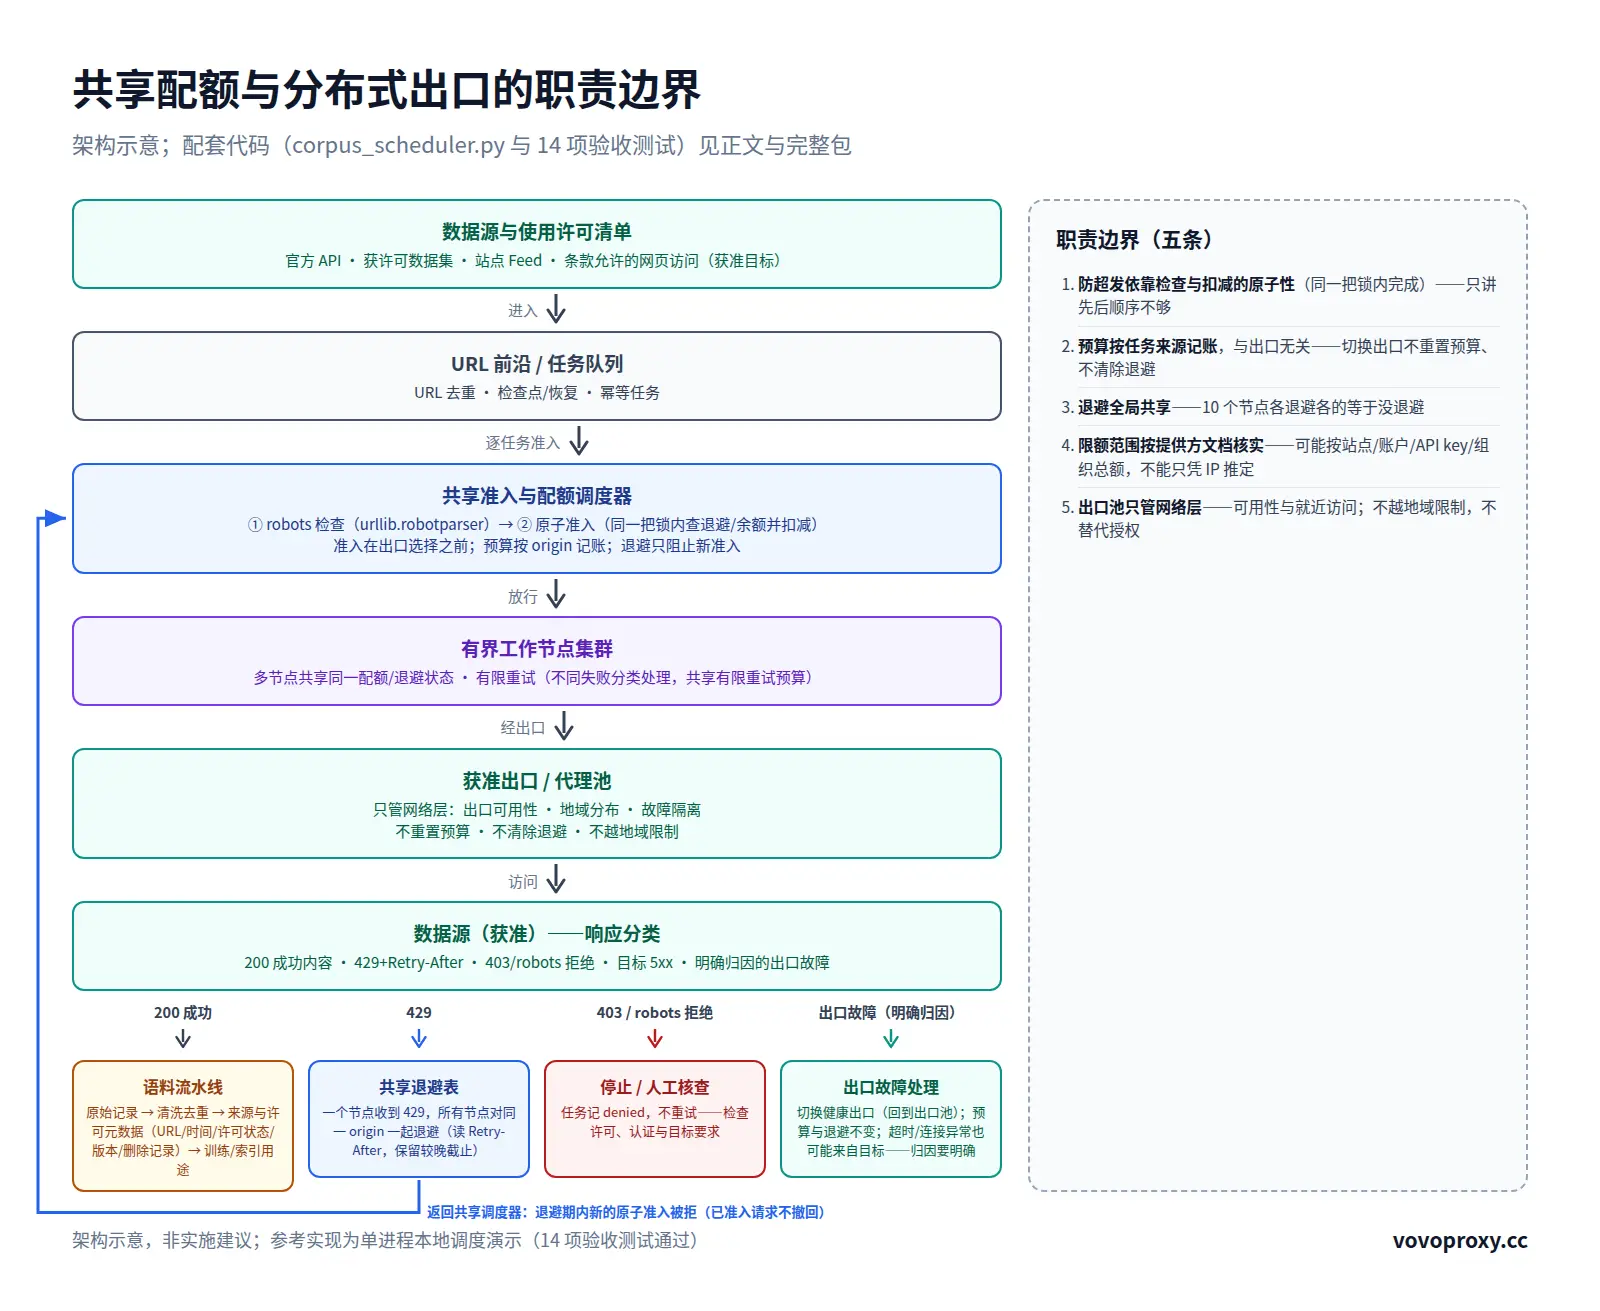
职责边界是这套架构的灵魂:
- 原子准入在出口选择之前。每个任务先过 robots 准入,再经原子准入(同一把锁内检查退避、检查余额、扣减预算,然后放行)——分离的"检查+扣减"在两个节点同时看到"剩余 1"时会各发一次,把预算扣成负数;注意退避只阻止新的准入,已准入、正在执行的请求不能撤回;
- 预算按任务来源记账,与出口无关。切换出口不重置预算、不清除退避——"从哪个出口出去"和"这个站点还允许我发多少"是两个独立的问题;
- 退避是全局共享的。任何一个节点收到 429,所有节点对同一 origin 的任务一起进入退避——否则 10 个节点各退避各的,等于没退避;
- 限额范围按提供方文档核实。配额可能按站点、账户、API key 或组织总额计算,不能只凭 IP 或 origin 推定——参考实现用 origin 作为本地演示的预算维度,真实系统的预算维度必须与目标的真实限流维度对齐;
- 出口池只管网络层。多地域出口提供的是可用性与地域分布(不同地区的站点就近访问),不能用于越过地域访问限制——那是授权问题,不是网络问题。
持续性的工程保障:检查点与恢复(done/denied 保留终态、中断的在途任务重新排队、配额与退避状态随检查点一并恢复——否则重启会重获预算、重复退避历史;注意任务状态与配额状态是分别保存、分别恢复的,本演示没有原子的联合持久化保证)、任务幂等(URL 去重、已完成任务恢复后不重抓)、有限重试(不同失败分类处理,共享有限重试预算)、增量更新。注意边界:参考实现是 URL 任务去重与内存状态快照——崩溃后的零重复处理未证明,语料内容入库不在演示范围。
语料质量与网络持续性是两回事:网络持续可用不等于语料适合训练或索引。每条语料应携带元数据:来源 URL、获取时间、许可状态(robots 允许的证据、数据集条款)、内容版本/哈希、删除记录(遵守 takedown)。Common Crawl 的实践值得对照:它公开了爬取代码、用 CCBot 身份明示自己、遵守 robots.txt、响应出版者的移除请求(Common Crawl)。
参考实现:本地调度演示
配套代码 corpus_scheduler.py 是分布式架构的单进程模拟(多线程模拟多个工作节点)——它演示调度层的核心不变量,不是完整基础设施(真实部署需要跨机器的服务共享状态存储与原子操作)。已运行验证的 14 项不变量:
 1. robots 不允许的任务不发送(准入在出口选择之前)
 2. 重复任务不重复入库(URL 去重)
 3. 原子准入:8 节点争用最后一个额度,只放行 1 次(并发不超发)
 4. 429 共享退避:退避公布后其他节点的准入被拒(backoff)、fetch 不被
    调用,到期后才恢复发送
 5. 退避保留较晚截止(后来的短退避不覆盖已有的长退避)
 6. 出口切换不重置预算(预算按 origin 记账)
 7. 配额耗尽 → 任务延期,有界终止
 8. 检查点恢复:done/denied 不重抓、inflight 重新排队、配额与退避
    一并恢复(不重获预算、退避截止保留)、deferred 由调用方显式重排队
 9. Retry-After 边界:整数秒(含 0)生效,None 回退默认值
    (参数为已解析数值;响应头解析由调用方实现)
10. 出口故障 → 切换出口重试,配额不退不增
11. 多节点并发处理全部任务
12. urllib.robotparser 解析(常用规则子集,非完整 RFC 9309 符合性验证)
13. robots 加载器 HTTP 夹具:200 解析允许规则;404/429/503 及网络错误保守拒绝
14. 端到端 HTTP:调度器收到真实 429 → 共享退避 → 重试不早于公布的
    退避截止时间 → 到期恢复完成
robots 准入层基于 Python 标准库的 urllib.robotparser(can_fetch
判断、crawl_delay/request_rate 查询,Python 文档)。三个边界要说明:crawl-delay 是非标准扩展(RFC 9309 未定义它,但
Common Crawl 等爬虫声明遵守);RFC 9309 对 robots.txt 获取失败的规定是——4xx 时爬虫"可以"访问任何资源(MAY)、5xx/不可达时必须假定完全禁止、持续 30
天不可达可按不可用处理(RFC
9309)——参考实现的加载器显式实现保守策略(非 200 一律按完全禁止处理,含 4xx),并以真实 HTTP 夹具验证了
200/404/429/503/网络错误五种情形,你可以按自己的合规定位调整;缓存方面,RFC 建议缓存不超过 24 小时,参考实现的 RobotsGate
缓存是"本次运行的固定规则快照",长期运行需自行实现定期刷新。
常见问题 FAQ
Q:加代理能提高我的访问额度吗?
A:不能。额度是目标授予的授权概念,代理只改变网络出口。用更多出口对同一目标提速,本质是规避其速率意图——正确做法是用官方 API 的配额通道,或降低频率。
Q:robots.txt 允许,是不是就能用于模型训练?
A:不是。robots.txt 管"能不能抓",不管"抓了能不能用"——RFC 9309 明确它不是访问授权机制(RFC
9309)。训练用途要单独核对版权与数据许可(对照 Common Crawl 条款把版权责任交给使用者的做法)。
Q:为什么不能遇到 429 就换 IP 重试?
A:429 是目标在告诉你"慢下来"。Retry-After 头(RFC 9110)就是给你的恢复时间表;共享退避 + 按目标降速才是可持续采集。换 IP 重发会把"速率问题"升级成"信任问题"。
Q:采集中断了怎么恢复?
A:检查点 + 幂等任务。参考实现的 TaskStore 演示了最小实现:任务与配额/退避状态的快照、恢复规则(done/denied 保留终态不重抓、中断的在途任务重新排队、deferred
由调用方恢复预算后显式重排队)——这是 URL 任务去重与内存状态快照,崩溃后的零重复处理未证明,语料内容入库不在演示范围。
Q:多地域出口有什么用?
A:网络层的可用性与就近访问(目标在不同地区时降低延迟、分摊出口故障)。它不能越过地域访问限制(那是授权问题),也不能替代配额调度(预算是共享的)。
总结
- 持续性 = 获准数据源 + 共享调度 + 故障恢复 + 可追溯语料,不是"不断换 IP 重试"——分布式代理池提供出口与故障隔离,不增加平台授予的总访问额度;
- 入口优先级:官方 API > 获许可数据集 > 站点 Feed > 条款允许的网页访问(Common Crawl);
- 限制分类处理:429 共享退避(读 Retry-After)、403/robots 检查许可、出口故障切换出口(预算不变)、目标 5xx 有限重试(MDN);
- 对照官方实践:OpenAI、Google、Common Crawl 的公开做法是"用途区分 + robots 遵守 + 可验证身份"(OpenAI、Google、Common Crawl)——你的采集器应该用同样的标准要求自己。
如果你的语料采集业务需要评估多地域出口网络环境,可以了解 VoVoProxy(以上为官网宣传信息,具体能力建议以实际咨询和测试为准),或直接通过 Telegram:@Tomhox、SafeW:@Tomhox 咨询——沟通时说明你的目标站点类型、采集规模与合规情况,便于评估合适的方案。