本文定位:面向技术用户与企业的网络科普,讨论代理断线的常见成因与"三网 BGP 中转"的技术原理。文中不虚构任何运营商实测数据,不把 BGP 写成"自动最快";跨境联网请遵守所在地法律法规。
先说结论:断线不一定是线路差
简短回答:代理频繁断线,通常有四类原因——连接质量(丢包/路由不稳定)、超时机制(客户端、代理、负载均衡或 NAT 的空闲超时)、资源容量(带宽、连接数、CPU 打满)、服务端故障(节点宕机、被攻击)。"换三网 BGP"只可能改善其中一部分;先定位断线发生在哪一层,再谈方案。
另一个需要先纠正的观念:"三网 BGP"不自动等于低延迟。BGP 的选路依据是策略而非实时延迟(下文详解);多运营商接入也只是"入口条件",不保证后续路径质量。把 BGP 当成"自动最快的路由协议",是这篇文章要拆掉的第一个误解。
第一步:判断断线发生在哪一层
| 表现 | 优先核对项 |
|---|---|
| TCP 连接建立失败 | 入口可达性、端口、节点服务状态 |
| 空闲一段时间后断开 | 客户端、代理、负载均衡器或 NAT 的超时设置 |
| 并发升高后大量失败 | 带宽、CPU、连接数、队列及连接跟踪表容量 |
| 连接存在但请求超时 | 丢包、重传、目标服务及应用层超时 |
注意:这是本文的排查框架——四类原因可能并存,不能仅凭现象确诊。下面逐层展开。
空闲断线:先查超时配置
一些"代理不稳定"与超时机制有关,而不是线路问题:
- 空闲的 TCP 连接默认没有"死亡检测":TCP 栈只有在尝试发送数据时才会发现连接已断;一端断网后,另一端的 socket 可以在 ESTABLISHED 状态停留很久。Cloudflare 的工程博客详细解释了这个机制,并介绍了 TCP keepalive 探测这一检测手段(Cloudflare:When TCP sockets refuse to die);
- 部分有状态中间设备可能按空闲超时清理连接状态:NAT 网关、负载均衡器、防火墙的常见实现会维护连接状态表,并对空闲会话计时。《High Performance Browser Networking》描述了移动网络 NAT 对连接设置超时、需要定期 keepalive 维持空闲连接的场景(HPBN:Optimizing for Mobile Networks);该资料还指出,部分 NAT 设备对 TCP 会话也套用超时逻辑(HPBN:Building Blocks of UDP)。
- RST 与超时是两种不同的断开:正常关闭走 FIN 交换;异常断开表现为 RST(立即丢弃连接状态)或超时。Cloudflare 的 Radar 团队把这类"异常关闭"列为网络问题的症状信号——原因可能是网络错误、中间设备干预、攻击等(Cloudflare:TCP resets and timeouts)。
实操建议:遇到空闲断开,先核查客户端、代理和中间设备的超时配置与日志;业务允许且组件支持时,再协调配置 TCP keepalive 或应用心跳,并与空闲超时协调。要注明边界:keepalive 不能保证所有中间设备保留状态,也不能修复容量不足或实际链路故障。
高并发断线:容量问题,不是玄学
并发升高后大量失败,瓶颈通常在这几处(分别核对,别混为一谈):
- 带宽余量:出口带宽打满后,排队延迟上升、丢包率上升——表现是"变慢"和"超时"同时出现;
- 连接处理容量:Linux 内核文档说明,打开的文件描述符是受 RLIMIT_NOFILE(ulimit -n)约束的逐进程资源,达到上限后可能无法继续分配文件描述符(Linux 内核文档);系统的连接跟踪表同样有容量上限(nf_conntrack_max,内核文档:nf_conntrack sysctl)。超过上限后的失败行为取决于软件、系统及部署;
- CPU 与队列:TLS 加密处理消耗 CPU,高并发下 CPU 资源不足会加剧延迟——具体表现取决于软件实现与部署;
- 三个指标不能混:并发连接数、每秒新建连接数、吞吐量是三个不同的容量维度——一个节点可能扛得住大量长连接,却扛不住高频的新建连接。
注意:BGP 本身不提供代理进程的处理容量;实际瓶颈和失败行为取决于软件、系统及部署。高并发稳定性方面,本文建议的一套工程机制是:容量监测与余量管理、连接上限与队列配置、节点健康检查与摘除、按负载扩容,以及各层超时策略的协调——这些是部署层面的建议,需要结合所用软件与系统的文档逐项落地。
跨网瓶颈从何而来:历史案例的观察
要理解"三网 BGP 中转"到底改善了什么,先看瓶颈在哪里。Cloudflare 在中国大陆建网的两篇工程博客(2015 年的分析与其后的京东云合作文),记录了其部署时期观察到的三类现象(反映观察时的情况,不概括当前全国状态):
- 多个独立网络:电信、联通、移动各自运营独立网络,跨省、跨网的互联点容量与质量参差不齐(Cloudflare:与京东云的合作);
- 互联点可能成为瓶颈:运营商网络之间的互联点是拥塞的常见位置——"流量太多而容量太少"(Cloudflare:2015 中国网络分析);
- 两种绕路现象:同一篇文章记录了两种不同案例——跨网直连质量太差时,流量绕出国再回来有时反而更高效;而对本应国内直达的流量,不必要的跨境绕行("长号路由")会带来数百毫秒的额外延迟。两个现象出现在不同案例中,不能合并成一条结论(同一来源)。
学术测量也支持"瓶颈在内"的判断:APNIC 2020 年的研究测量了到中国大陆入境的跨国连接,发现大部分测得瓶颈位于国内网内(71% 的案例),且吞吐与拥塞呈昼夜规律(白天差、半夜好)——研究同时说明,拥塞可能是自然容量不足,也可能有人为限速因素(APNIC:Characterizing transnational Internet performance in China,2020 年入境连接测量,不代表当前状态)。
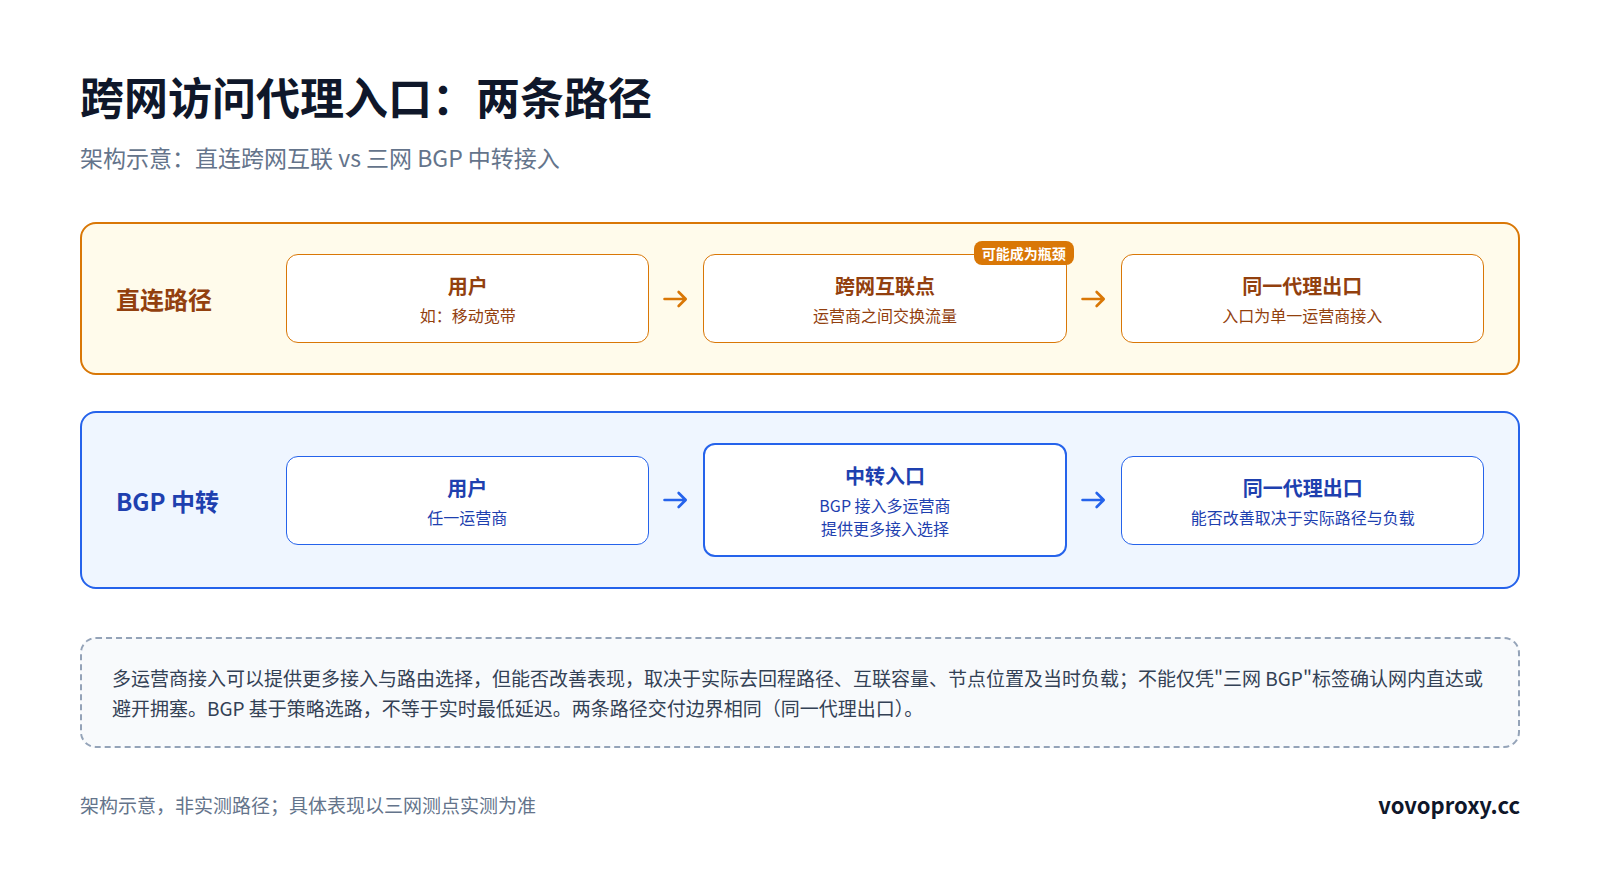
这就是中转的市场逻辑:如果代理入口只接入单一运营商(例如只有电信),联通和移动用户跨网访问这个入口,就要挤跨网互联点;如果入口通过 BGP 接入多家运营商,就提供了更多的接入与路由选择。但要注明边界:能否实际改善,取决于实际去回程路径、互联容量、节点位置及当时负载——不能仅凭"三网 BGP"标签确认网内直达或避开拥塞。
BGP 中转是什么:策略选路,不是"自动最快"
维基百科对 BGP 的定义:边界网关协议是自治系统(AS)之间交换路由与可达性信息的标准协议,属于路径矢量协议,基于路径、网络策略或管理员配置的规则集做路由决策。选路因素包括本地优先级(LOCAL_PREF)、AS 路径长度、来源类型等——没有一条是"实时延迟最低"。
所以"三网 BGP 中转"的准确含义是一组需要向供应商逐项确认的条件,而不是一个统一的产品规格:
- 接入条件:中转入口实际接入了哪些运营商(电信/联通/移动各多少带宽)?"三网"是接入宣传还是实测可达?
- 选路策略:入口如何为不同运营商的用户选路?出口到目标地区走什么路径?
- 故障路径:某条入口故障时是否有替代路径?切换粒度是什么?
- 交付边界:带宽是独享还是共享?SLA 条款覆盖哪些指标(可用性、延迟、丢包)?
同样要澄清"直连"这个词的两种含义:客户端到代理入口的直连(不经中转)与运营商之间的直连互联(不经第三方绕路)是两回事,很多争论把两者混在一起。
直连与中转:何时改善,何时更糟
没有实测数据就无法给排行榜,但可以给条件化的对照:
| 场景 | 直连(不经中转) | 经 BGP 中转 |
|---|---|---|
| 跨网访问入口(用户与入口不同运营商) | 跨网路径质量需实测,取决于当时拥塞 | 提供更多接入与路由选择;能否改善取决于实际路径、互联容量与负载 |
| 用户与入口同运营商 | 不自动意味着最优路径,直连可能更优也可能更差 | 增加一跳中转,是否更差取决于中转质量 |
| 中转节点自身拥塞 | —— | 可能成为新瓶颈 |
| 高并发容量 | 取决于节点资源 | 同样取决于节点资源,BGP 不增加容量 |
结论是条件化的:中转可能改变接入及后续路径;是否改善连接表现,需要在相同测点、同一代理出口和相近负载条件下验证。入口之后的路径质量、节点容量、出口质量,都要单独评估。所谓"杂牌节点",本质是资源、容量与运维信息不透明的节点——判断依据是透明度,不是品牌大小。
怎样验证"极速稳定"
向服务商(或自己动手)要这些证据,而不是看形容词:
- 连接成功率与建立耗时:从三网各一个测点,测连接建立的成功率与时间分布;
- 请求延迟分位数:报 P50/P95/P99,而不是只报平均值;
- 超时率与丢包率:并发测试必须同时记录失败请求——只展示成功请求的低延迟是无效数据;
- 持续吞吐:长连接下载测试,观察是否随时间衰减(缓冲区/限速问题);
- 故障演练:问清入口或出口故障时的切换机制。BGP 路由变化影响的是后续数据包的转发路径,不区分新旧 TCP 连接——若端点地址和必要状态保持、短暂中断未超过相关超时,已有连接可能继续工作;若代理端点、NAT 映射或有状态设备发生不兼容变化,则可能中断。路由收敛与代理故障转移不是同一机制,应分别测试。
另外两个测试常识:单一云端测点的数据不能代表三网;ping 正常不代表代理可用(ICMP 与 TCP/应用层走的是不同处理路径,中间设备对两者的处理也可以不同)。同样要注意,低延迟不等于无丢包,高带宽也不等于低抖动——这几组指标相关但不等价,要分别测。
如果你的团队在评估多运营商接入的中转方案,可以了解 VoVoProxy。据其官网介绍,它提供国内三网 BGP 中转、原生住宅与 ISP 独享 IP 资源(官网称覆盖 200+ 国家与地区)、SOCKS5/HTTP 支持,以及 7×24 工程师支持(以上均为 VoVoProxy 官网 宣传信息,建议以实际咨询和测试为准)。
常见问题 FAQ
Q:BGP 一定比直连快吗?
A:不一定。BGP 基于策略选路,不含"实时最低延迟"原则(维基百科)。同运营商直连也不自动意味着最优路径;中转的价值场景是跨网访问入口的更多接入选择,以及在实际具备独立可用替代路径时的入口故障冗余,能否改善要看实际路径与负载。
Q:为什么 ping 值正常,代理还是超时?
A:ping 用 ICMP,代理走 TCP/UDP——中间设备对两者的处理路径可以不同;ICMP 正常只说明"包能到",不说明 TCP
连接建立、应用层请求都正常。排查要以实际业务的连接成功率与请求延迟为准。
Q:换了路由,旧连接会断吗?
A:不一定。BGP 路由变化影响的是后续数据包的转发路径,不区分新旧 TCP 连接:若端点地址和必要状态保持、短暂中断未超过相关超时,已有连接可能继续工作;若代理端点、NAT
映射或有状态设备发生不兼容变化,则可能中断。路由收敛与代理故障转移不是同一机制,做故障演练时应分别测试。
Q:独享节点就不会拥塞吗?
A:不一定。独享解决的是"别人不抢你的节点资源",但出口带宽、上游互联容量、目标服务的处理能力仍可能成为瓶颈;节点到目标的路径拥塞也与独享无关。容量问题要用并发测试验证。
Q:代理空闲一段时间就断,是节点不行吗?
A:不一定是节点问题。空闲断开的一个常见排查方向是超时机制:先核查客户端、代理和中间设备的超时配置;业务允许且组件支持时,可配置 TCP keepalive
或应用心跳,并与空闲超时协调。要注明边界:keepalive 不能保证所有中间设备保留状态,也不能修复容量不足或实际链路故障。
总结
"频繁断线"是一个需要分层定位的问题,不是一句"节点不行"能概括的:
- 先定位层:分别核查入口与服务状态、超时配置、处理容量、网络及目标服务——这些是排查方向,不是仅凭现象即可确定的原因;
- 再看路径:三网 BGP 中转提供的是更多接入与路由选择——能否改善取决于实际去回程路径、互联容量、节点位置与负载;它不增加容量、不保证最低延迟、不承诺会话不断——这些是需要向供应商逐项确认的条件;
- 最后要证据:连接成功率、延迟分位数、超时率、故障切换行为——用可复现的测试清单代替形容词。
评估中转方案时,可以访问 VoVoProxy 官网 了解三网 BGP 中转与全链路服务,或通过 Telegram:@Tomhox、SafeW:@Tomhox 咨询。沟通时说明你的团队分布、并发规模与目标地区,便于评估入口接入与容量方案。